WEKA הישראלית הגדילה פי 3.7 את תפוקת מעבדי ה-AI בניסוי עם נביוס
17 נובמבר, 2026
החברה פיתחה טכנולוגיה המאפשרת למעבדים גרפיים לשמר מידע בין משימות ולצמצם חישובים חוזרים. הניסוי ממחיש כיצד ניהול הזיכרון הופך לגורם מרכזי בעלויות ההרצה של מערכות בינה מלאכותית
הניסוי נועד להמחיש בעיה שהולכת ומחריפה בתשתיות AI: מעבדים גרפיים יקרים מבזבזים חלק ניכר מכוח החישוב שלהם על חזרה על פעולות שכבר ביצעו. הבעיה בולטת במיוחד ביישומים המבוססים על סוכני AI, המבצעים משימות מורכבות לאורך זמן, תוך מעבר בין פעולות שונות ושימוש חוזר במידע שנצבר בשלבים הקודמים.
המעבד עסוק, אבל לא בהכרח מתקדם
כאשר מודל AI מעבד בקשה, הוא שומר בזיכרון מהיר מידע על ההקשר של השיחה או המשימה, באמצעות מנגנון המכונה KV Cache. כך, כאשר הוא ממשיך לשלב הבא, אין צורך לעבד מחדש את כל המידע הקודם. אלא שקיבולת הזיכרון המהיר של המעבד הגרפי (HBM) מוגבלת, וכאשר המערכת משרתת משתמשים וסוכנים רבים במקביל, היא נאלצת לפנות ממנו מידע כדי לפנות מקום למשימות אחרות.
כאשר סוכן חוזר למשימה קודמת, המערכת עשויה להידרש לחשב מחדש את המידע שפונה. המעבד ממשיך לעבוד ולצרוך חשמל, אך במקום לקדם את המשימה הוא משחזר עבודה שכבר בוצעה.
הטכנולוגיה של WEKA, הנקראת Augmented Memory Grid ופועלת במסגרת פלטפורמת NeuralMesh, נועדה להתמודד עם הבעיה באמצעות יצירת שכבת זיכרון משותפת המבוססת על כונני NVMe מהירים. במקום למחוק מידע שהתפנה מהזיכרון הגרפי ולחשב אותו מחדש, המערכת שומרת אותו בשכבת האחסון ומאפשרת למעבדים שונים לגשת אליו בעת הצורך.
בניסוי עם נביוס התברר כי במערכת שהתבססה על זיכרון ה-GPU בלבד, כ-60% מעבודת העיבוד הראשוני (Prefill) הוקדשו לחישוב מחדש של מידע שכבר עובד. לאחר שילוב הטכנולוגיה של WEKA ירד השיעור ל-6.8% בלבד.
כתוצאה מכך גדלה תפוקת הטוקנים לכל שעת GPU פי 3.7. במקביל, שיעור הבקשות שהושלמו בהצלחה וקיבלו תגובה ראשונית בתוך חמש שניות עלה מ-44% ל-97%. לפי החברות, המערכת ללא הטכנולוגיה הייתה נדרשת לכ-30 שעות כדי להפיק את כמות הפלט שהמערכת המשודרגת הפיקה בשמונה שעות. מדובר בתוצאות של ניסוי בתצורה מסוימת, ולא בהכרח בשיפור שניתן להשיג בכל עומס עבודה.
מדד חדש לכלכלת ה-AI
במקביל לניסוי, הציגה WEKA בכנס Supercomputing 2026 בשיקגו, בשיתוף חברת המחקר NAND Research, מסגרת חדשה למדידת יעילותן של תשתיות Inference, כלומר מערכות המשמשות להרצת מודלים לאחר שלב האימון.
המסגרת, Inference Economics Scorecard, כוללת תשעה מדדים, ובהם מספר הטוקנים המופקים לכל ואט חשמל, עלות הרצת המודל, זמני התגובה, ניצול הזיכרון ומספר הסוכנים שניתן להפעיל במקביל. מטרתה להעביר את הדגש משיעור ניצול המעבד הגרפי להיקף העבודה המועילה שהוא מסוגל להשלים.
לפי נתוני חברת המחקר 451 Research מבית S&P Global, חלקן של תשתיות ההרצה בהוצאות על תשתיות AI צפוי לגדול מ-34% בשנת 2026 ל-46% בשנת 2030.
WEKA הוקמה בשנת 2013 על ידי לירן צביבל, עומרי פלמון ומאור בן דיין, יוצאי חברת XIV שנרכשה על ידי IBM. החברה התמקדה בתחילת דרכה בהאצת מערכות אחסון ארגוניות, ובהמשך התרחבה לתשתיות נתונים עבור מחשוב עתיר ביצועים ובינה מלאכותית. בשנת 2024 גייסה 140 מיליון דולר לפי שווי של 1.6 מיליארד דולר. בין המשקיעים בחברה נמצאת גם אנבידיה.
הפעילות החדשה ממחישה את התרחבות שוק תשתיות ה-AI מעבר לשבבים עצמם. ככל שיותר ארגונים עוברים מאימון מודלים להפעלה רציפה של סוכני AI, ניהול הזיכרון והמידע הופך לגורם מרכזי בקביעת העלות והתפוקה של מרכזי הנתונים.
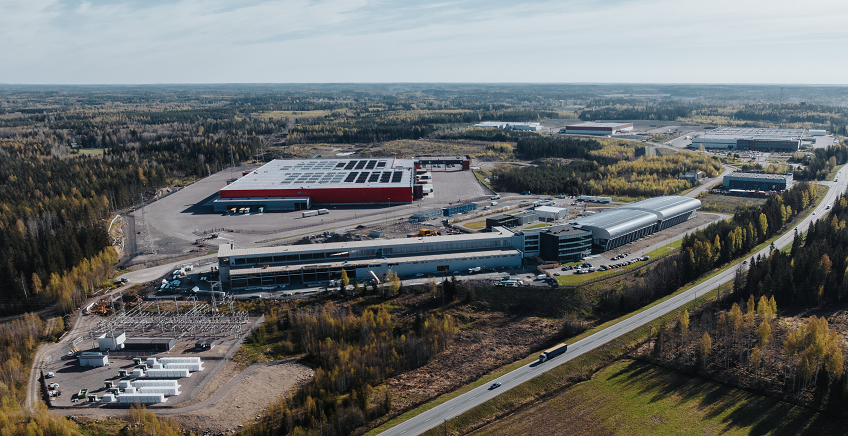
[בתמונה: דאטה סנטר של נביוס בפינלנד. מקור: נביוס]
פורסם בקטגוריות: חדשות